kafka
概述
由Linkedin公司开发,是一个分布式、支持分区(partition)、多副本的基于zk协调的分布式消息系统,由scalar语言编写
特性
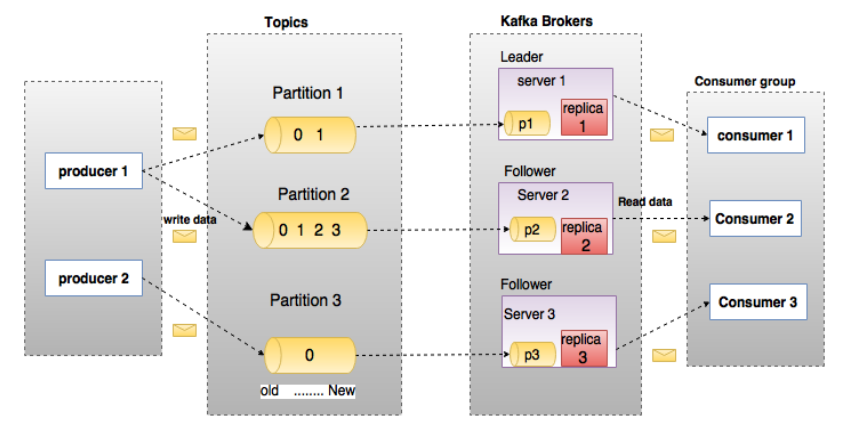
高吞吐量、低延迟:kafka每秒可以处理几十万条消息,它的延迟最低只有几毫秒,每个topic可以分多个partition, consumer group 对partition进行consume操作。
可扩展性:kafka集群支持热扩展
持久性、可靠性:消息被持久化到本地磁盘,并且支持数据备份防止数据丢失
容错性:允许集群中节点失败(若副本数量为n,则允许n-1个节点失败)
高并发:支持数千个客户端同时读写
使用场景
日志收集:一个公司可以用Kafka可以收集各种服务的log,通过kafka以统一接口服务的方式开放给各种consumer,例如hadoop、Hbase、Solr等。
消息系统:解耦和生产者和消费者、缓存消息等。
用户活动跟踪:Kafka经常被用来记录web用户或者app用户的各种活动,如浏览网页、搜索、点击等活动,这些活动信息被各个服务器发布到kafka的topic中,然后订阅者通过订阅这些topic来做实时的监控分析,或者装载到hadoop、数据仓库中做离线分析和挖掘。
运营指标:Kafka也经常用来记录运营监控数据。包括收集各种分布式应用的数据,生产各种操作的集中反馈,比如报警和报告。
流式处理:比如spark streaming和storm
事件源
名词解释
- Broker:消息中间件处理节点,一个Kafka节点就是一个Broker,一个或者多个Broker可以组成一个Kafka集群。
- Topic:Kafka 的消息通过 Topic主题来分类,Topic类似于关系型数据库中的表,每个Topic包含一个或多(Partition)分区。
- Partition: 多个分区会分布在Kafka集群的不同服务节点上,消息以追加的方式写入一个或多个分区中。
- LogSegment:每个分区又被划分为多个日志分段 LogSegment组成,日志段是 Kafka 日志对象分片的最小单位。LogSegment算是一个逻辑概念,对应一个具体的日志文件(”.log” 的数据文件)和两个索引文件(”.index” 和 “.timeindex”,分别表示偏移量索引文件和消息时间戳索引文件)组成。
- Offset: 每个分区中都由一系列有序的、不可变的消息组成,这些消息被顺序地追加到 Partition 中,每个消息都有一个连续的序列号称之为 Offset 偏移量,用于在 Partition 内唯一标识消息。
- Message: 消息是 Kafka 中存储的最小最基本的单位,即为一个 commit log,由一个固定长度的消息头和一个可变长度的消息体组成。
- Producer: 消息的生产者,负责发布消息到KafkaBroker,生产者在默认情况下把消息均衡地分布到主题的所有分区上,用户也可以自定义分区器来实现消息的分区路由。
- Consumer: 消息的消费者,从 Kafka Broker 读取消息的客户端,消费者把每个分区最后读取的消息的 Offset偏移量保存在 Zookeeper 或 Kafka 上,如果消费者关闭或重启,它的读取状态不会丢失。
- ConsumerGroup: 每个Consumer属于一个特定的Consumer Group(若不指定 GroupName则属于默认的 group),一个或多个 Consumer组成的群组可以共同消费一个 Topic 中的消息,但每个分区只能被群组中的一个消费者操作。
- Leader:每个partition有多个副本,其中有且仅有一个作为Leader,Leader是当前负责数据的读写的partition。
- Follower:Follower跟随Leader,所有写请求都通过Leader路由,数据变更会广播给所有Follower,Follower与Leader保持数据同步。如果Leader失效,则从Follower中选举出一个新的Leader。当Follower与Leader挂掉、卡住或者同步太慢,leader会把这个follower从“in sync replicas”(ISR)列表中删除,重新创建一个Follower。
安装
步骤
1.下载kafka和zookeeper
2.启动zookeeper
3.配置kafka中 /config/server.properties
4.启动kafka ./kafka-server-start.sh ../config/server.properties
当前环境:
192.168.38.133
kafka:/home/soft/kafka_2.13-2.5.0/bin
zk:/home/soft/zookeeper-3.4.14/bin
配置
server.properties主要更改点:
broker.id=1 //实例名称
cluster.id=qiuqiu-133
listeners=plaintext://192.168.38.133:9092 //监听地址
zookeeper.connect=localhost:2181/kafka //zk地址
log.dirs=/home/logs/kafka/log //内容日志地址
kafka有2个地方地址
1.请求日志/home/logs/kafka/logs,home/logs/kafka/bin/kafka-run-class.sh更改目录地址
2.内容日志/home/logs/kafka/log,server.properties更改地址
DEMO
实操部分
kafka 2.2.7–>内部用到org.springframework.lang.Nullable
springframework 4.3.9 没有org.springframework.lang.Nullable
kafka降级为 1.2.2
数据流
图片:https://www.jianshu.com/p/d3e963ff8b70
生产端
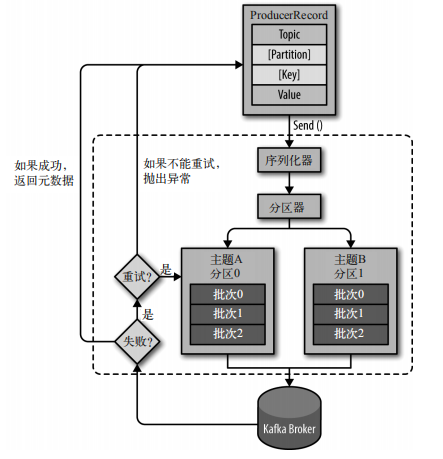
必选属性
1 | bootstrap.servers borker地址清单 |
常用配置
1 | acks 0,1,all 。分别代表:不需要回应,首领节点回应,所有节点回应 buffer.memory 生产者缓存区大小,缓冲要发送到服务器的消息 |
消费端
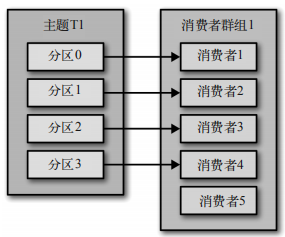
消费者数量不要超过分区数量,多了的消费者只会闲置
必选属性
1 | Properties props = new Properties(); props.put("bootstrap.servers", "broker1:9092,broker2:9092"); props.put("group.id", "CountryCounter"); props.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer"); KafkaConsumer consumer = new KafkaConsumer(props); consumer.subscribe(Collections.singletonList("customerCountries")); |
常用配置
1 | fetch.min.bytes 从服务器获取消息的最小字节数 |
监控台-Kafka Eagle
admin 123456
spring kafka
@KafkaListener注册步骤
1.
@EnableKafka目的是创建一个KafkaListenerAnnotationBeanPostProcessor,重点看方法postProcessAfterInitialization,完善endpoint的对象,获取类型为KafkaListenerContainerFactory的factroy对象,注册一个端点,registerEndpoint,存储到该类的一个List
2.
KafkaListenerAnnotationBeanPostProcessor(注册bean的后置处理器来方便拦截bean的创建,使得bean在创建前会有这个拦截)->afterSingletonsInstantiated->registerListenerContainer,创建所有的listenerContainer,每个消费者都有一个listenerContainer
3.运行
在AbstractMessageListenerContainer.doStart(),设置的并发数,每个消费者*n
1 | for (int i = 0; i < this.concurrency; i++) { KafkaMessageListenerContainer container; if (topicPartitions == null) { container = new KafkaMessageListenerContainer<>(this.consumerFactory, containerProperties); |
kafka核心知识
发送模式
high level api:kafka自己维护在Zookeeper上,不需要人工干涉.属于at least once.如果message消费失败并且没有commit offset,当消费线程重启后会重复消费这个message.
low level api:发送方维护offset信息, commit offset+1.属于at most once.
offset更新的方式
自动提交,设置enable.auto.commit=true,更新的频率根据参数【auto.commit.interval.ms】来定。这种方式也被称为【at most once】,fetch到消息后就可以更新offset,无论是否消费成功。
手动提交,设置enable.auto.commit=false,这种方式称为【at least once】。fetch到消息后,等消费完成再调用方法【consumer.commitSync()】,手动更新offset;如果消费失败,则offset也不会更新,此条消息会被重复消费一次。
多副本同步-acks机制
这里的策略,服务端这边的处理是follower从leader批量拉取数据来同步。但是具体的可靠性,是由生产者来决定的。生产者生产消息的时候,通过request.required.acks参数来设置数据的可靠性。
ACKS 参数指定了必须要有多少个分区副本接收到消息,生产者才会认为消息写入是发送消息成功的,这个参数对消息丢失的可能性会产生重要影响,主参数有如下选项:
- acks=0: 把消息发送到kafka就认为发送成功。
- acks=1: 把消息发送到kafka leader分区,并且写入磁盘就认为发送成功。
- acks=all: 把消息发送到 Kafka Leader 分区,并且 Leader 分区的副本 Follower 对消息进行了同步就认为发送成功。
partition的分配
- 将所有Broker(假设共n个Broker)和待分配的Partition排序
- 将第i个Partition分配到第(i mod n)个Broker上 (这个就是leader)
- 将第i个Partition的第j个Replica分配到第((i + j) mode n)个Broker上
offset的保存
一个消费组消费partition,需要保存offset记录,该记录保存在__consumeroffsets topic中。写进消息的key由groupid、topic、partition组成,value是偏移量offset
reblance场景
增加partition
增加消费者
消费者主动关闭
消费者宕机了
coordinator自己也宕机了
消息投递语义
At least once
先获取数据,再进行业务处理,业务处理成功后commit offset。1、生产者生产消息异常,消息是否成功写入不确定,重做,可能写入重复的消息 2、消费者处理消息,业务处理成功后,更新offset失败,消费者重启的话,会重复消费
At most once
先获取数据,再commit offset,最后进行业务处理。1、生产者生产消息异常,不管,生产下一个消息,消息就丢了 2、消费者处理消息,先更新offset,再做业务处理,做业务处理失败,消费者重启,消息就丢了
Exactly once
首先要保证消息不丢,再去保证不重复。所以盯着At least once的原因来搞。首先想出来的:
生产者重做导致重复写入消息—-生产保证幂等性
消费者重复消费—消灭重复消费,或者业务接口保证幂等性重复消费也没问题
broker常用配置
| 配置项 | 作用 |
|---|---|
| broker.id | broker的唯一标识 |
| auto.create.topics.auto | true-遇到没有的topic自动创建topic |
| log.dirs | log目录 |
| listeners | 监听地址 |
| zookeeper.connect | zk地址 |
topic配置
| 配置项 | 作用 |
|---|---|
| num.partitions | 新建一个topic,会有几个partition。 |
| log.retention.ms | 对应的还有minutes,hours的单位。日志保留时间,因为删除是文件维度而不是消息维度,看的是日志文件的mtime。 |
| log.retention.bytes | partion最大的容量,超过就清理老的。注意这个是partion维度,就是说如果你的topic有8个partition,配置1G,那么平均分配下,topic理论最大值8G。 |
| log.segment.bytes | 一个segment的大小。超过了就滚动。 |
| log.segment.ms | 一个segment的打开时间,超过了就滚动。 |
| message.max.bytes | message最大多大 |
文件存储
在分区日志文件中,你会发现很多类型的文件,比如:.index、.timestamp、.log、.snapshot 等,其中,文件名一致的文件集合就称为 LogSement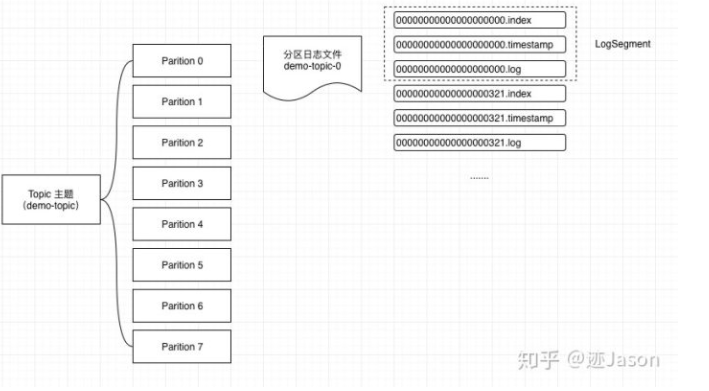
0000*.index 偏移量索引文件
0000*.timeinde:time index 时间戳索引文件
0000*.log 日志文件
0000*.snapshot 是Kafka 为幂等型或事务型Producer 所做的快照文件
leader-epoch-checkpoint:用于保存 leader 的 epoch 信息,为了解决 HW 更新时机是异步延迟的,而 HW 又是决定日志是否备份成功的标志,从而造成数据丢失和数据不一致的现象
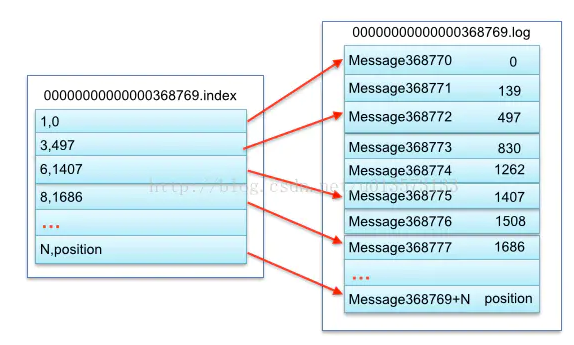
segment index file采取稀疏索引存储方式,为数据文件的每个对应message设置一个元数据指针
在partition中如何通过offset查找message
第一步查找segment file
第二步查找物理偏移地址
第三步查找log日志,顺序查找直到这条message为止。
具体详细说明:https://zhuanlan.zhihu.com/p/65415304
HW(high watermark)

管理kafka
创建主题
3个参数:主题名称,复制系数,分区
./kafka-topics.sh –zookeeper 192.168.38.133:2181/kafka –create –topic qiuqiu-test-create2 –replication-factor 2 –partitions 2
删除主题
配置中:delete.topic.enable=true
./kafka-topics.sh –zookeeper 192.168.38.133:2181/kafka –delete –topic qiuqiu-test-create
./kafka-topics.sh –delete –topic simpleTopic –zookeeper 192.168.38.133:2181
增加分区
./kafka-topics.sh –zookeeper 192.168.38.133:2181/kafka –alter –topic simpleTopic –partitions 2
列出集群里所有主题
./kafka-topics.sh –zookeeper 192.168.38.133:2181/kafka –list
./kafka-topics.sh –zookeeper 192.168.38.133:2181/kafka –describe
查看消费具体内容
../bin/kafka-console-consumer.sh –bootstrap-server 192.168.38.133:9092 –topic mysql-kafka-cc_selection_group –from-beginning
查看偏移量
分区中位移
./kafka-run-class.sh kafka.tools.GetOffsetShell –broker-list 192.168.38.133:9092 -topic simpleTopic
各个分区当前最大的消息位移值
./kafka-run-class.sh kafka.tools.GetOffsetShell –broker-list 192.168.38.133:9092 –topic simpleTopic –time -1
各个分区当前最小的消息位移值
./kafka-run-class.sh kafka.tools.GetOffsetShell –broker-list 192.168.38.133:9092 –topic simpleTopic –time -2
查看消费情况
./kafka-consumer-groups.sh –bootstrap-server 192.168.38.133:9092 –describe –group simpleBatchGroup

列出消费者群组
新版本:./kafka-consumer-groups.sh –new-consumer –bootstrap-server 192.168.38.133:9092/kafka-cluster –list
旧版本:./kafka-consumer-groups.sh –zookeeper 192.168.38.133:2181/kafka –describe –group testGroup
删除群组
./kafka-consumer-groups.sh –bootstrap-server 192.168.38.133:9092 –delete –group testGroup
删除偏移量
./kafka-consumer-groups.sh –zookeeper 192.168.38.133:2181/kafka –delete –group testGroup –topic my-topic
导出偏移量
./kafka-run-class.sh kafka.tools.ExportZkOffsets –zkconnect 192.168.38.133:2181/kafka –group testGroup –output-file offsets
导入偏移量
./kafka-run-class.sh kafka.tools.ImportZkOffsets –zkconnect192.168.38.133:2181/kafka–input-file offsets
覆盖主题默认配置
kafka-configs.sh –zookeeper zoo1.example.com:2181/kafka-cluster
–alter –entity-type topics –entity-name
–add-config
覆盖客户端默认配置
kafka-configs.sh –zookeeper zoo1.example.com:2181/kafka-cluster
–alter – entity-type clients –entity-name
–add-config
列出被覆盖的配置
./kafka-configs.sh –zookeeper 192.168.38.133:2181/kafka –describe –entity-type topics –entity-name qiuqiu-kafka-topics2
移除被覆盖的配置
./kafka-configs.sh –zookeeper 192.168.38.133:2181/:2181/kafka –alter – entity-type topics –entity-name qiuqiu-kafka-topics2
手动启动副本选举
./kafka-preferred-replica-election.sh –zookeeper 192.168.38.133:2181/kafka
修改分区副本、修改复制系数
kafka-reassign-partitions.sh 略-kafka权威指南p149
转储日志片段
./kafka-run-class.sh kafka.tools.DumpLogSegments –files /home/logs/kafka/log/qiuqiu-test-create2-0/00000000000000000000.log
检查无用的索引
./kafka-run-class.sh kafka.tools.DumpLogSegments –files /home/logs/kafka/log/qiuqiu-test-create2-0/00000000000000000000.index,/home/logs/kafka/log/qiuqiu-test-create2-0/00000000000000000000.log –index-sanity-check
副本验证
./kafka-replica-verification.sh –broker-list 192.168.38.133:9092,192.168.38.133:9093 –topic-white-list ‘.*’
不安全的操作(操作zk)
移动集群控制器,删除/controller
取消分区重分配,1.删除 /admin/reassign_partitions 节点,2.删除/controller
手动删除主题,1.删除 /brokers/topics/TOPICNAME,2.删除每个 broker 的分区目录,这些目录的名字可能是 TOPICNAME-NUM,其中 NUM 是指分区的 ID。3.重启
与RabbitMQ比较
kafka 支持高流量,但是消息就被当作简单有序的 log,侧重于消息共享,不能做太多的基于逐条消息的处理。
rabbitMQ 支持中小流量,但是在消息处理上有很大的灵活性。